Una galleria tra dati, curve e alberi decisionali per esplorare la sopravvivenza sul Titanic. Allenare un modello richiede poche righe; capire che cosa abbia imparato è un’altra storia.
Il Titanic è uno dei primi incontri di chi si avvicina al machine learning: una specie di “Hello, World!” con dati mancanti, variabili categoriche e un contesto storico tragico. La competizione Titanic di Kaggle propone un compito preciso: usare le informazioni sui passeggeri per prevederne la sopravvivenza.
Nel mio notebook in Python ho affrontato il problema con pandas, Seaborn e XGBoost. Prima osserviamo i dati, poi costruiamo le variabili e infine chiediamo al modello di rendere conto delle sue previsioni.
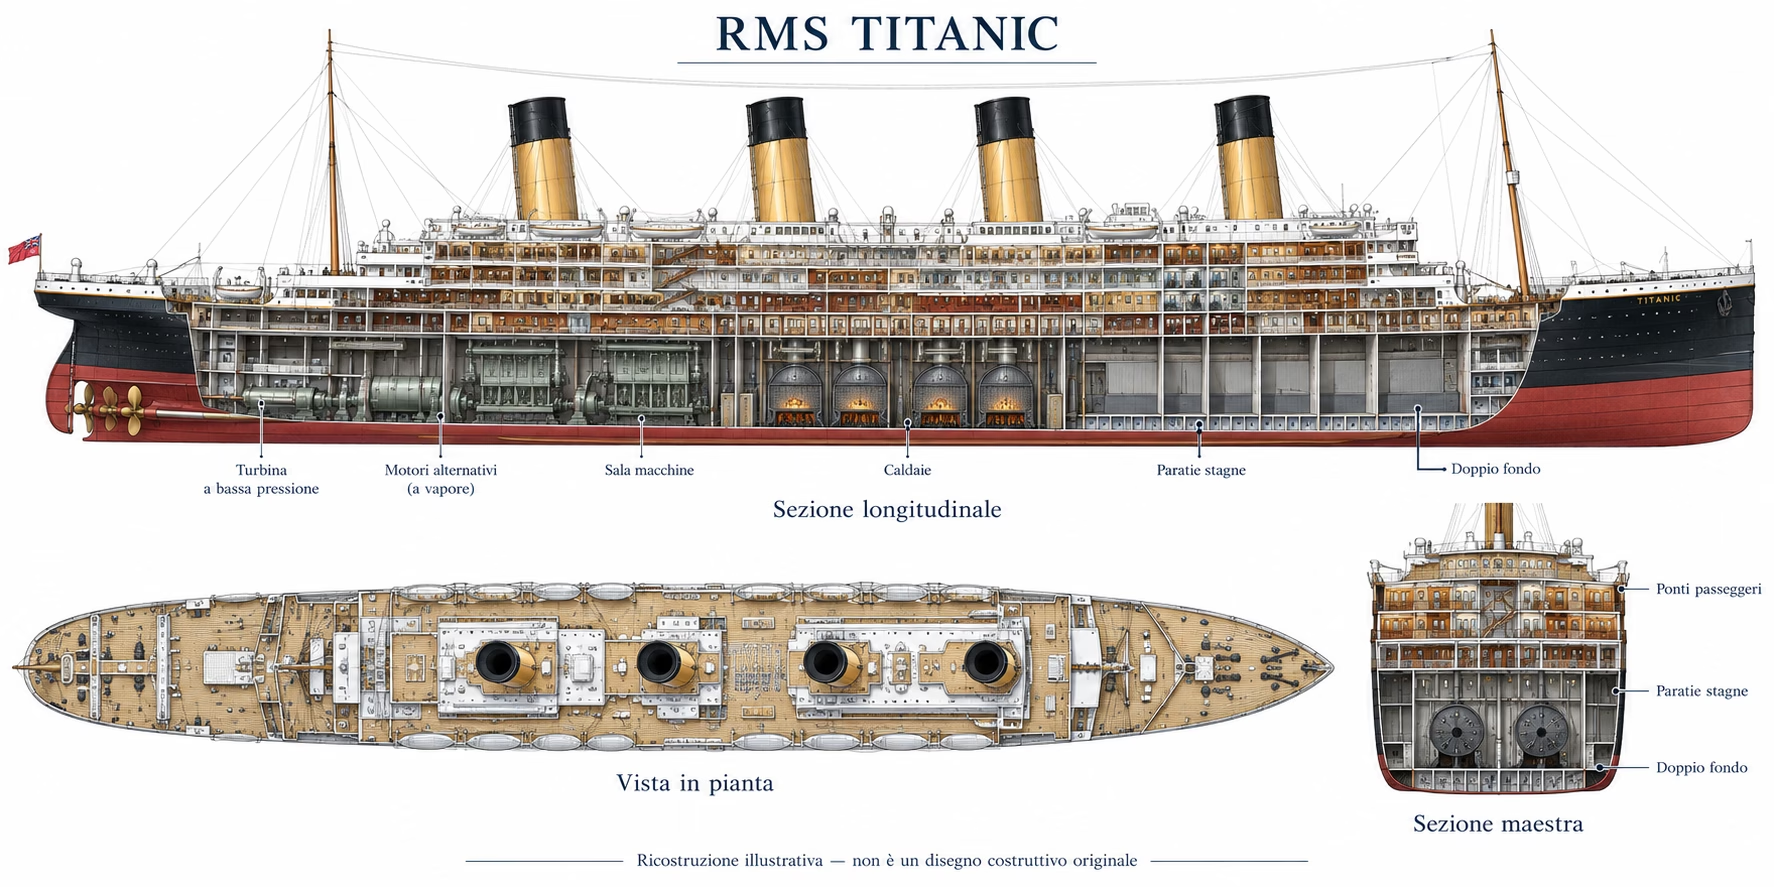
Il manifesto passeggeri diventa un dataset
Il training set contiene 891 passeggeri di cui conosciamo l’esito. Per altri 418, nel test set, dobbiamo generare le previsioni. Abbiamo sesso, età, classe del biglietto, tariffa, cabina, porto d’imbarco e numero di familiari a bordo. Nel training set mancano però 177 età e 687 informazioni sulla cabina. Prima della fantascienza, l’inventario.
Come leggere la galleria: Survived = 0 indica i non sopravvissuti; Survived = 1 i sopravvissuti. I colori vanno letti attraverso la legenda di ogni figura. Fai clic sui grafici per aprirli ingranditi.
1. Il biglietto era già una feature
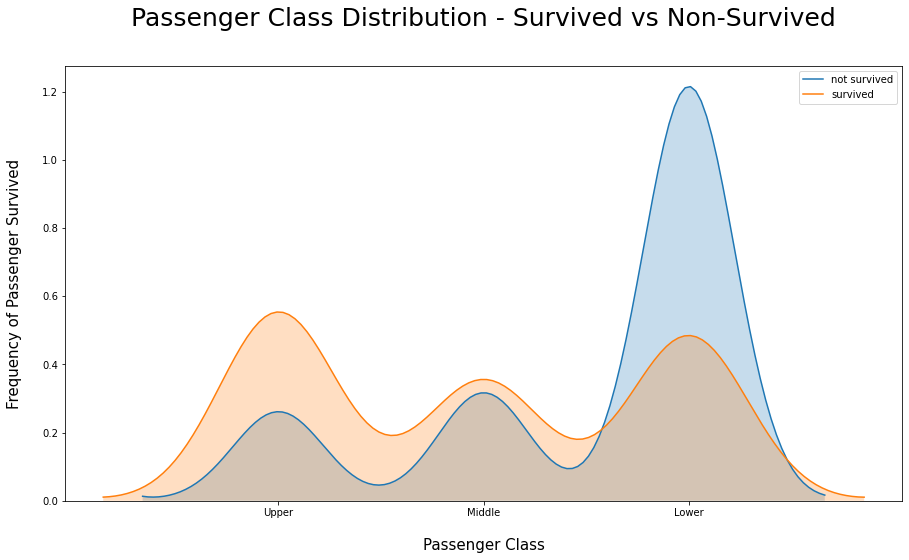
La classe è un buon punto di partenza per esplorare il rapporto tra condizioni di viaggio e sopravvivenza. Queste curve mostrano distribuzioni, non tassi di sopravvivenza per classe: un picco più alto non equivale automaticamente a una maggiore probabilità di salvarsi. La KDE smussa una variabile con soli tre valori. Nessuno viaggiava in classe 1,7: è la rappresentazione a essere continua.
2. Prima del modello, l’identikit
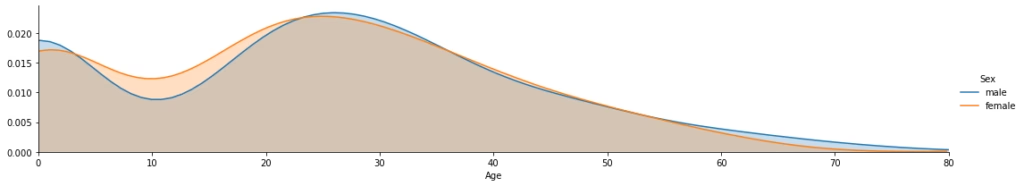
Prima di interpretare le differenze di esito, conviene capire chi stiamo osservando. Qui il colore distingue il sesso, non la sopravvivenza. Le curve confrontano la forma delle distribuzioni; i conteggi vanno cercati nei dati. Nelle KDE sull’età, i valori mancanti sono sostituiti con −0,5: limitare l’asse visibile a zero non li esclude dal calcolo e può influenzare la curva vicino all’origine.
3. La trama si divide in sei pannelli
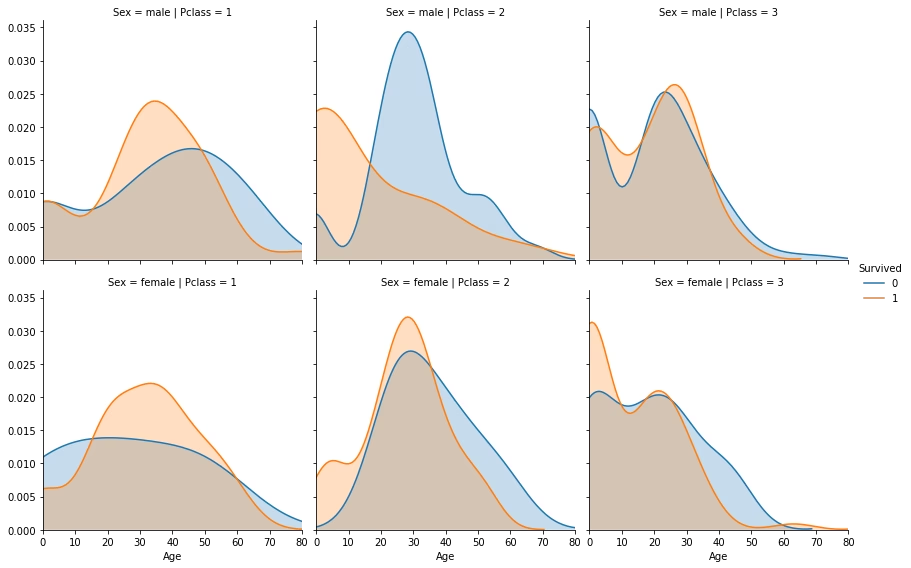
Incrociare le variabili rende le domande più interessanti. Il rapporto tra età e sopravvivenza cambia tra le classi? Il quadro è simile per uomini e donne? La griglia aiuta a esplorare queste combinazioni. L’altezza delle densità non rappresenta una probabilità individuale: normalizzazione e numerosità dei gruppi contano.
4. Una regex sul manifesto passeggeri
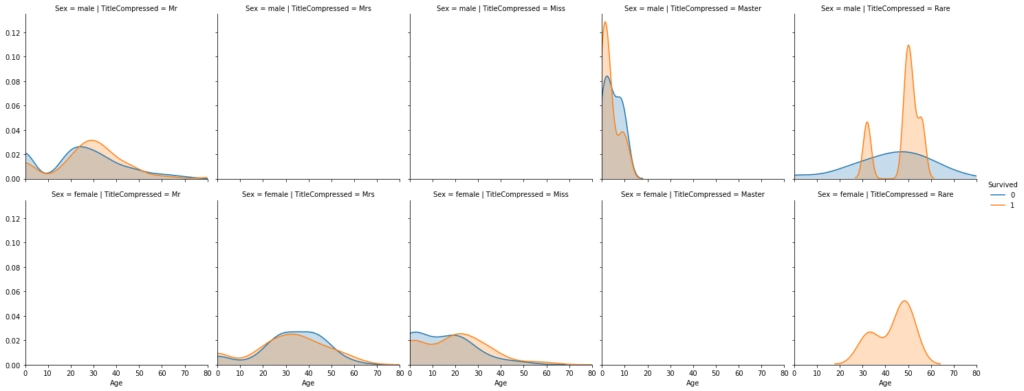
Il campo Name contiene più di un nome: una semplice estrazione restituisce titoli come Mr, Mrs, Miss e Master. Normalizzo alcune varianti e raggruppo i titoli meno frequenti in Rare. È feature engineering: rendere esplicita un’informazione già presente. La regex trova il titolo; interpretarlo richiede più lavoro. Una curva elegante non aumenta magicamente un campione piccolo.
5. Ogni punto, un passeggero
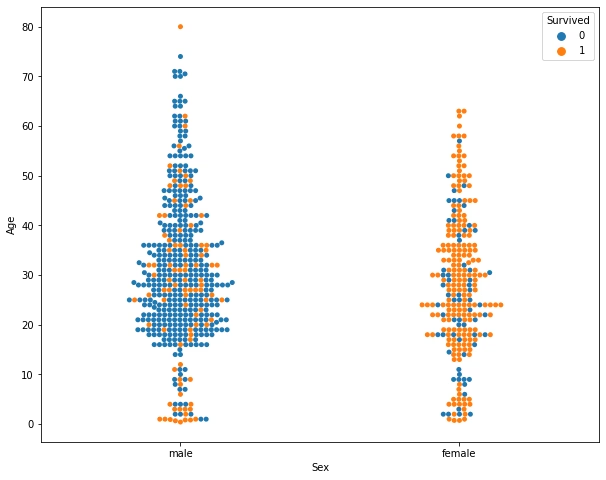
Dopo le curve, torniamo ai singoli casi. Lo swarmplot sposta lateralmente i punti per ridurne la sovrapposizione: la posizione all’interno di ciascun gruppo serve alla leggibilità, non rappresenta una nuova variabile. Una tendenza lascia spazio a molte eccezioni.
6. Stessi dati, un altro spartito
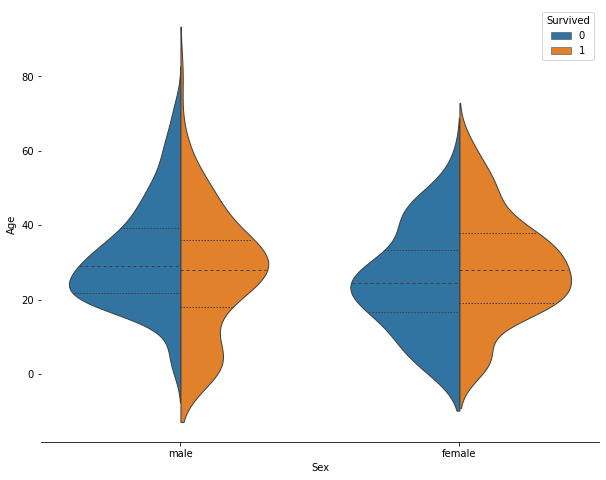
Curve, punti e violini: sembra un concerto sperimentale, invece è Seaborn. La sagoma riassume la densità stimata dell’età, sui record con età maggiore di zero. Le parti larghe indicano concentrazione nella distribuzione rappresentata; non sono automaticamente conteggi assoluti. I quartili aiutano a orientarsi.
7. Tre classi, più di tre storie
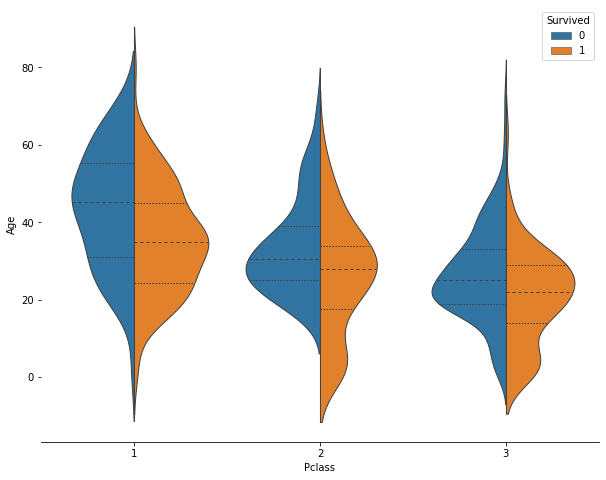
Cambiamo raggruppamento: dal sesso alla classe. Forme e quartili fanno emergere differenze che una sola media nasconderebbe. La classe è associata anche ad altre caratteristiche del viaggio: esploriamo associazioni, senza isolare un effetto causale.
8. La distribuzione torna una folla
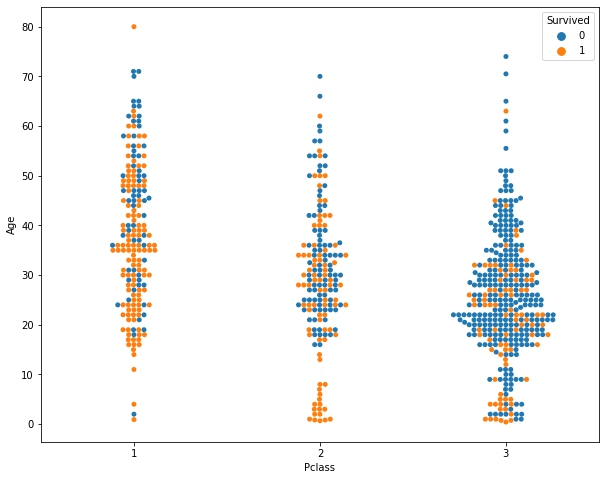
Stesse variabili, rappresentazione diversa. Accanto ai violini, i punti mostrano che cosa c’è dietro la sagoma: dove si addensano i casi, dove sono pochi e quanto è eterogeneo ciascun gruppo. Passiamo dalla sintesi alla granularità.
9. Coordinate di bordo, con zone d’ombra
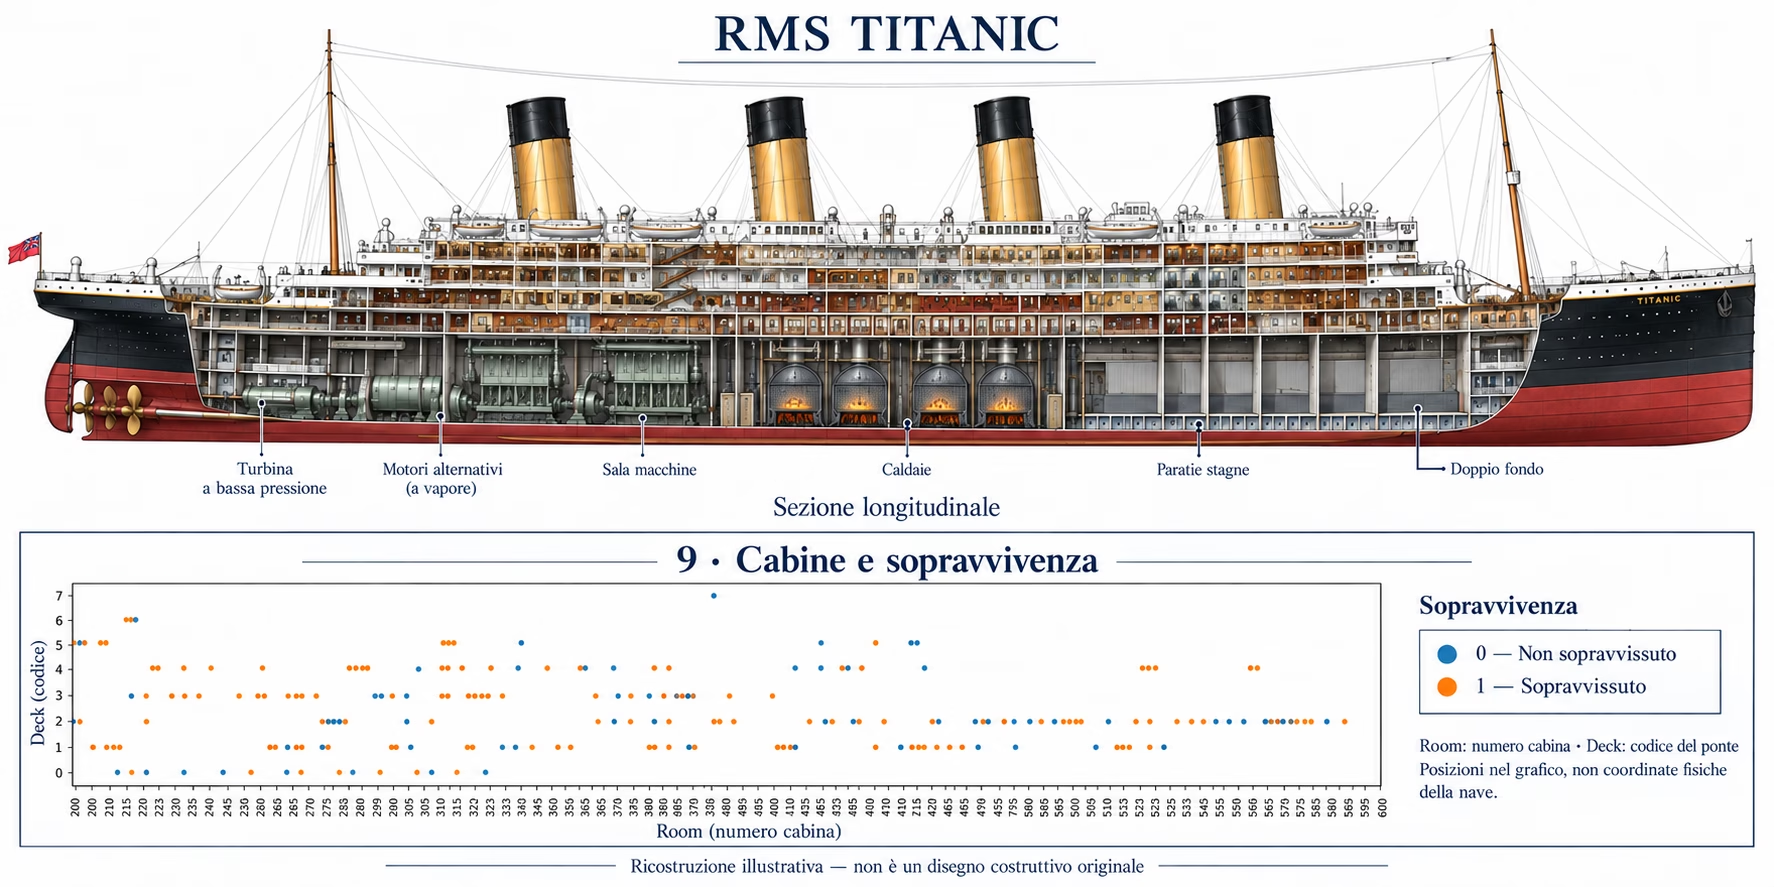
Dalla cabina ricavo il ponte e una componente numerica della stanza. Questa figura non è una planimetria: il numero estratto non è una coordinata spaziale continua e DeckLE è una codifica delle categorie. La cabina manca per 687 passeggeri del training set: il sottoinsieme visualizzato non va assunto come rappresentativo dell’intero campione.
10. Chi viaggiava in quale classe?
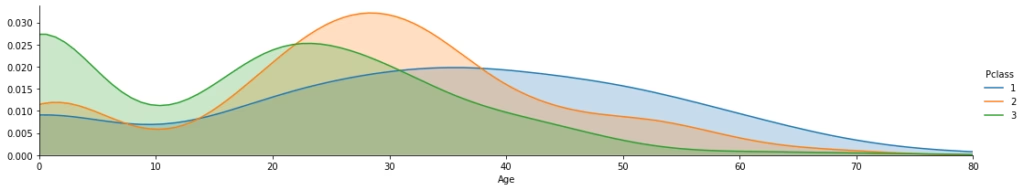
Torniamo alla composizione del campione. Gruppi con età differenti richiedono cautela anche nel confronto aggregato degli esiti. Qui il colore identifica la classe, non la sopravvivenza. Vale la nota sulle età mancanti codificate con −0,5 e sul loro effetto vicino all’origine.
11. Il radar delle feature
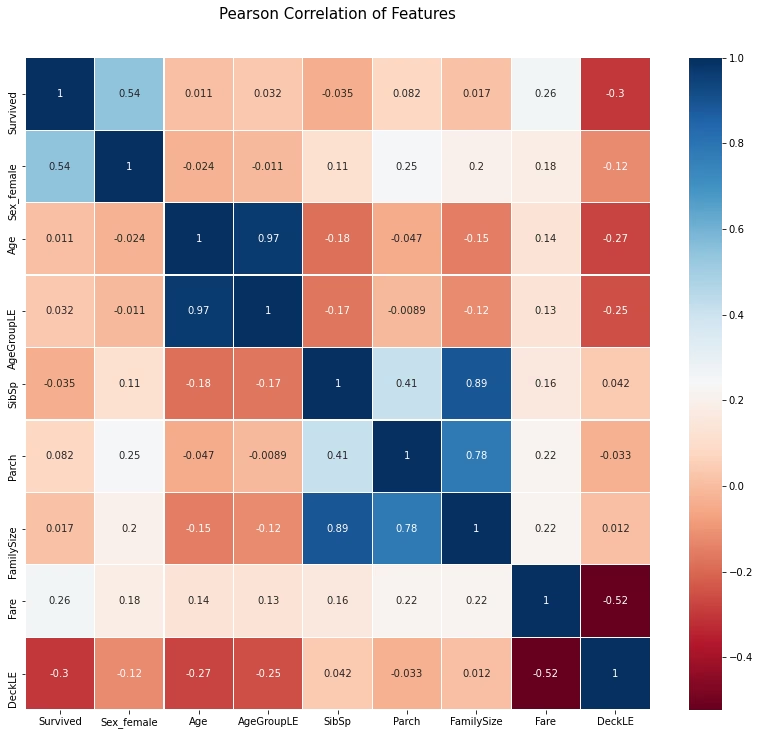
La heatmap raccoglie molte associazioni in una sola immagine. Correlazione non significa causalità, e una correlazione lineare debole può nascondere interazioni o relazioni non lineari. Le codifiche contano: Age include il segnaposto −0,5; DeckLE assegna numeri anche al ponte sconosciuto. FamilySize deriva da SibSp + Parch + 1: alcune celle raccontano anche come abbiamo costruito i dati.
Dall’esplorazione alle feature del modello
Nel notebook preparo fasce d’età, dimensione della famiglia, informazioni sulla cabina e titoli estratti dal nome. Per alcune categorie uso il one-hot encoding, creando colonne indicatrici. Esplorare una variabile non implica usarla nel modello finale: la selezione mostrata comprende sesso, classe, familiari, ponte codificato, alcune fasce d’età e porto d’imbarco. Anche le etichette meritano attenzione: Teenager copre l’intervallo oltre i 14 e fino ai 25 anni. Il nome è comodo; gli estremi definiscono il gruppo.
Il boss di fine tutorial: la baseline
Prima di convocare XGBoost, bisogna confrontarsi con una regola elementare: prevedere la sopravvivenza per tutte le donne e la non sopravvivenza per tutti gli uomini. Nell’articolo originale questa baseline raggiunge uno score Kaggle di 0,76555, circa il 76,6%. Arriva senza tuning e ci obbliga a dimostrare quanto serva la complessità aggiunta.
XGBoost entra in scena
XGBoost implementa il gradient boosting: una sequenza di alberi i cui contributi cercano progressivamente di ridurre l’errore del modello. Nel notebook riservo il 30% dei dati etichettati alla validazione e uso l’early stopping controllando la log loss.
| Insieme | XGBoost | Baseline sullo stesso insieme |
|---|---|---|
| Addestramento: 623 passeggeri | 87,159% | 78,491% |
| Validazione: 268 passeggeri | 79,478% | 79,104% |
Sulla validazione il vantaggio è di circa 0,37 punti percentuali: una classificazione corretta in più su 268 passeggeri. È un miglioramento piccolo, da verificare con ulteriori suddivisioni o una validazione più ampia. Lo score Kaggle della baseline riguarda un insieme diverso dalla validazione locale: la loro differenza non misura direttamente il vantaggio del modello. Il Best Score di 0,77511 mostrato su Kaggle è associato alla versione 24; i risultati qui riportati provengono dalla versione 32. Le cifre hanno una provenienza: tenerla visibile fa parte dell’analisi.
Che cosa resta dopo la galleria
Questo esperimento riunisce gestione dei dati mancanti, costruzione delle feature, visualizzazione, addestramento e verifica. I punti mostrano le osservazioni, curve e violini ne riassumono la forma, le griglie mettono in relazione i gruppi e la heatmap suggerisce associazioni da approfondire.
Il notebook completo su Kaggle contiene codice, analisi e risultati. Far girare XGBoost richiede poche righe. Capire se quelle righe hanno imparato qualcosa richiede tutte le domande che vengono prima — e qualche controllo dopo.